だいぶ、ひさしぶりの更新になります。
私事ですが、住んでいる市の広報に、息子と一緒に写真入りの記事が掲載されていました。
長岡京市は、天下分け目の天王山がある「山崎の合戦」の地に近いところで、もっと昔は都があったところで、なんだか文化的に面白いところです。
市域自体はそんなに大きくなくて、8万人くらいの街なのですが、アットホームなところもあって気に入っています。
2025-11-20の近況
11月になって急に寒くなりました。両親の実家の長崎から大量にみかんが送られてきたので、風邪予防に毎日食べています。みかんの袋の数を毎日記録する日々です(10-11個が多いようです)。
(2025-12-24追記)今日はクリスマスイブです。息子の通う小学校でインフルエンザの大流行があり、息子もすぐに感染しましたが、元気に回復して、無事クリスマスを迎えることができそうです。
BLASTを自分のPC内で動かす
はじめに
個人のPCなどのローカルな環境でBLAST検索を行う方法について。
サンプルデータ
今回は、Tachysurus (Pseudobagrus) ussuriensis(ギギの仲間、中国に分布)で同定された性決定候補遺伝子(16遺伝子)について、その遺伝子と相同なタンパク質アミノ酸配列を、日本のネコギギTachysurus ichikawaiのゲノムに対してBLAST検索を行い、それらの遺伝子の存在・コピー数およびゲノム上の位置を調べる。
参考論文はこちら。
Insights into chromosomal evolution and sex determination of Pseudobagrus ussuriensis (Bagridae, Siluriformes) based on a chromosome-level genome | DNA Research | Oxford Academic
データベース(ゲノム配列)
ネコギギ(Tachysurus ichikawai)のドラフトゲノムアセンブリを使用する。このサイトからファイル(FASTAの2つのファイル)をダウンロードし、適切なディレクトリにファイルを置いてから、以下のコマンドで一つにまとめる(以下のコマンドで生成されるFASTA file"BAABVT01.scaffolds.nt.fna"を以下では使用)。
# ファイルを一つにまとめる
gzip -dc BAABVT01.[12].fsa_nt.gz | cat > BAABVT01.nt.fna
# Scaffold名をわかりやすく変更
perl -pe "s/BAABVT01[0-9]+\.1 Tachysurus ichikawai Psic_f4_3 DNA\, //" BAABVT01.nt.fna |perl -pe "s/\, whole genome shotgun sequence//" > BAABVT01.scaffolds.nt.fna
クエリ配列(Pseudobagrus ussuriensisの性決定候補遺伝子)
BLAST検索の問い合わせ(クエリ)配列は、NCBIのデータベースから入手する。
(注)ちょっとややこしいのは、今回は中国産ギギそのものの性決定候補遺伝子(<-- 現時点で公開されていない)ではなくて、その遺伝子と相同な(別の魚の)データベース上の遺伝子のアミノ酸配列を使う、ということである。そこで、クエリとなる遺伝子のタンパク質アミノ酸配列を、Accession IDをもとにNCBI Protein DBから入手して使用する。
参考論文のTable 5に、性決定候補遺伝子のリストがある。またTable S8は、性決定領域に連鎖した遺伝子のリストなので、Table 5でリストアップされている遺伝子の遺伝子名(たとえばChr08.223)を、Table S8から探す。
Table S8の"Chr08.223"の行は以下のようになっているので、L列目(NR_Protein)のAccession IDをコピーする(ここではXP_026765674.1)。

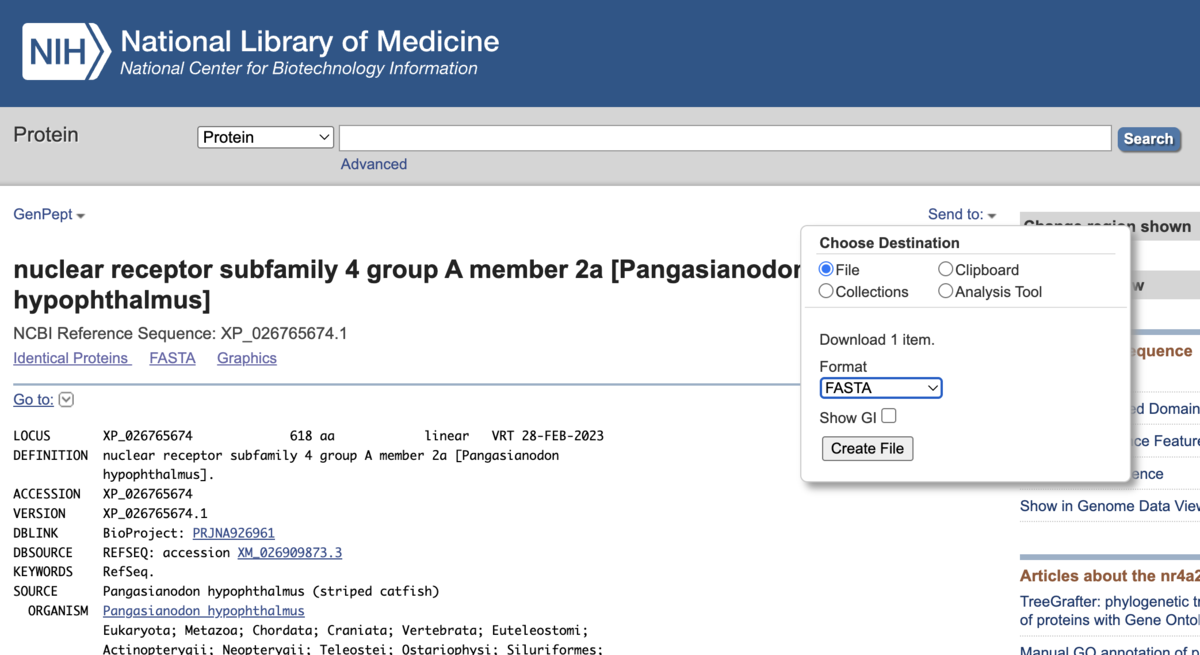
NCBI Proteinのページから、コピーしたAccession IDで検索して、目的のアミノ酸配列のFASTAファイルをダウンロードする。適当なファイル名(この例ではXP_026765674.1.fastaなど)で保存する。ファイルはデータベースのファイルがあるディレクトリに適当な名前のディレクトリを作り、その中に保存する(ここでは"sex_determining_genes_Table5")。
ローカル環境でのBLASTの実行
BLASTのインストール
Condaの仮想環境にインストールする。
conda create -n blast
conda activate blast
conda install bioconda::blast
BLAST DBの作成
データベースとなるネコギギゲノムについて、以下のコマンドを実行してBLASTのデータベースを作成する。
# BLAST DBの作成
makeblastdb -dbtype nucl -in BAABVT01.scaffolds.nt.fna -hash_index
TBLASTNの実行
ここでは、例でダウンロードした遺伝子のアミノ酸配列をクエリとしてローカルでTBLASTN(アミノ酸配列をクエリに、塩基配列のデータベースを検索)を行う。以下のようにコマンドを実行する。
# TBLASTNを実行 threads数は環境によって調整する
tblastn -num_threads 12 -db BAABVT01.scaffolds.nt.fna -query sex_determining_genes_Table5/XP_026765674.1.fasta -max_target_seqs 3 > sex_determining_genes_Table5/XP_026765674.1.tblastn.out
結果の確認
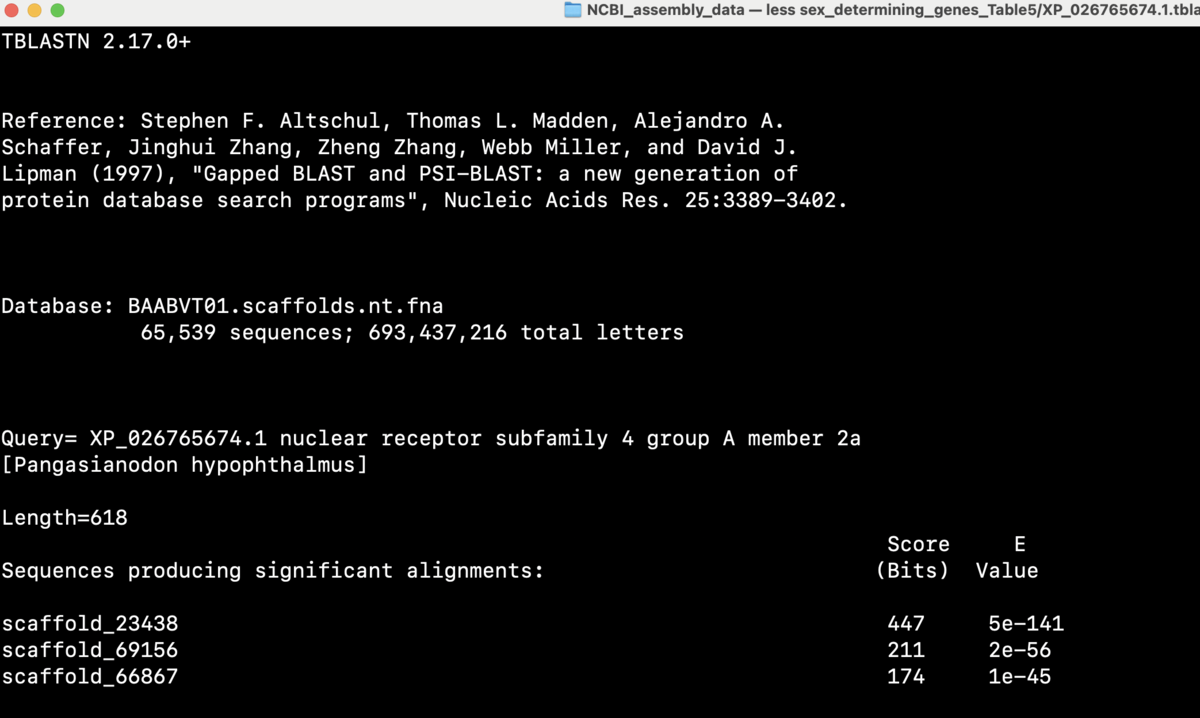
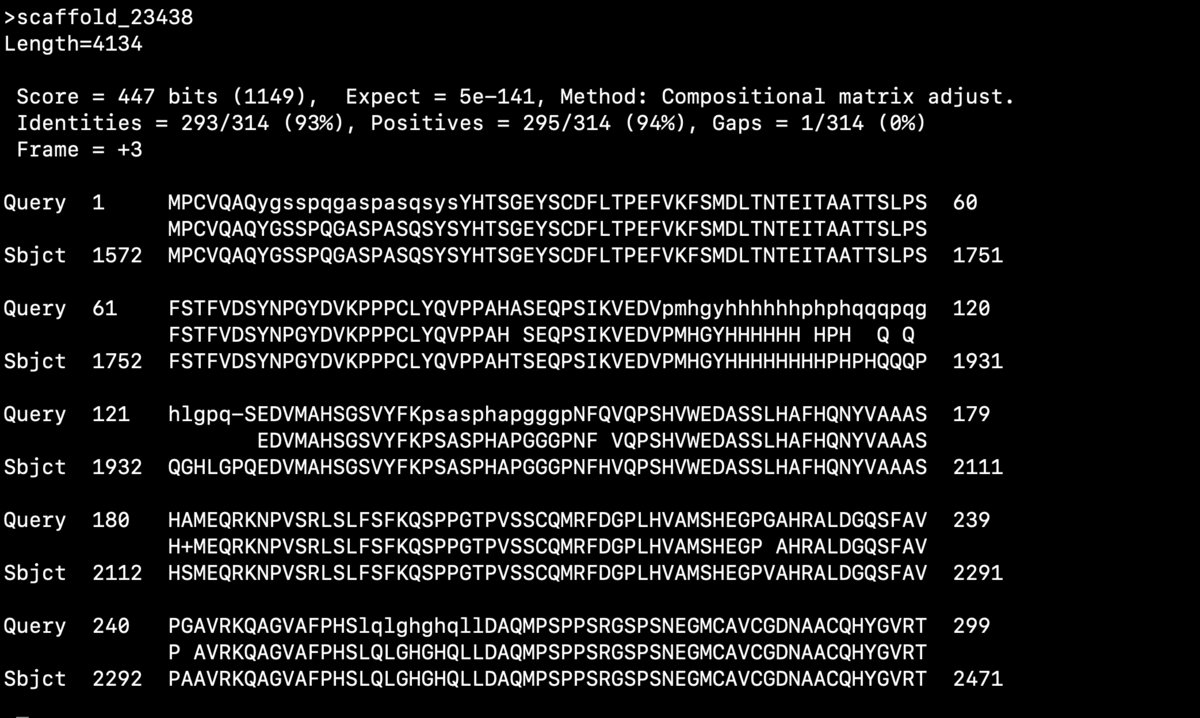
TBLASTNの結果は、クエリのFASTAファイルと同じフォルダに保存している。以下のコマンドで結果を確認する。
less sex_determining_genes_Table5/XP_026765674.1.tblastn.out
参考URL
- 中国ギギのゲノムアセンブリ
Tachysurus ussuriensis genome assembly ASM4025621v1 - NCBI - NLM
- ネコギギのドラフトゲノムを報告している論文
https://esj-journals.onlinelibrary.wiley.com/doi/10.1002/1438-390X.12183
PacBioのHiFiリードからミトゲノムを選択して再構成するMitoHiFi(使用メモ)
最近、PacBioのHiFiリードからミトコンドリアゲノムを選択して再構成するMitoHiFiを使用する機会があったので、その使用メモです。
はじめに
ロングリードのゲノムアセンブリから、ミトコンドリアゲノム(ミトゲノム)のみを抽出して使用したい場合があります。ミトゲノムのみでの分子系統解析は下火になったとはいえ、たとえば最近の環境DNA分析では、ミトコンドリア遺伝子の一部が使われるケースが多く、環境DNAバーコーディングのプライマーを作成する場合など、ミトゲノムを調べる必要があります。
しかし、ロングリードのアセンブリに含まれるミトゲノムのコンティグは、ミトゲノムが「わずか」約16kbの「環状DNA」であるという条件から、正確なアセンブリができていないケースが多いようです。16kbというのは、PacBioのHiFiリードでも、Nanoporeでも、「そんなに長くない」、むしろ「短い」部類のリードなので、一つのリードで全長をカバーしていることが多いです。その結果、個々のリードがどこから読まれるかによって、異なる開始点〜終止点を持つミトゲノム全長リードが複数できてしまい、(基本的に)環状DNAを考慮しないHiFiASMやCanuなどでそれらをアセンブルすることで、同一の配列が複数回繰り返し出現するような「長い」コンティグになってしまうことがあります。
これを避けるためには、ロングリードに含まれる「ミトコンドリアDNAのリード」を選択的に抽出し、それらのリードをもとに「環状DNAに対応した」アセンブルを行う必要があります。MitoHiFiはPacBioのHiFiリードについてこのような解析を行い、ミトゲノムの全長を再構成した上でミトコンドリア遺伝子のアノテーションを行うパイプラインです。具体的な方法としては、同種または近縁種のミトゲノムに対してMinimap2を用いてリードをマップし、ミトゲノムのリードを同定したのち、そのリードをHiFiASMでde novoアセンブルするようです。アセンブルされたミトゲノムの配列に対する遺伝子アノテーションまで、続けて行ってくれます。
実際の解析例
ここでは、NCBI SRAに登録されているNeosalanx brevirostris(魚類:アリアケヒメシラウオの仲間)の全ゲノムのHiFiリード(SRR31112376)を例に、実際に解析を行います。
準備
MitoHiFiのインストール
Dockerのコンテナがあるので、それを使用します。ここではSingularityを使います。
# コンテナのダウンロードおよび作成
singularity build mitohifi.sif docker://ghcr.io/marcelauliano/mitohifi:master
サンプルデータのダウンロード
SRA Toolkitを使ってダウンロードしたのち、bgzipで圧縮します(約16.7 GB)。bgzipのインストール方法はこちら。
fasterq-dump SRR31112376
bgzip -@ 32 SRR31112376.fastq
MitoHiFiの実行
同種または近縁種のミトゲノムをデータベースから検索してダウンロードする
# make new folder (mtgenome)
mkdir mtgenome
# singularityを使用
# ここでは"Neosalanx brevirostris"またはその近縁種のミトゲノムを検索 まず同一種を検索、なければ近縁種を探す
singularity exec -B ${PWD}:${PWD} mitohifi.sif findMitoReference.py --species "Neosalanx brevirostris" --outfolder mtgenome --min_length 14000
ここでは、同属の近縁種N. oligodontisのミトコンドリアゲノム(PQ668635.1)がダウンロードされて、"mtgenome"フォルダにそのFASTAおよびGenBankファイルが保存されました。
結果
出力されるファイル
解析が終了すると、複数のフォルダとファイルが生成されますが、最終結果のファイルは、以下になります。


2025-02-18の近況
早くも2月後半ですが、寒い日が続きますね。集中講義など大きな仕事が終わって少し落ち着きましたが、あいかわらずいろいろと仕事が続きます。(2025.2.18)


